
Пропало отрицание
Распознанный текст разрешает то, что оригинал исключает. Сравнить всю фразу, примечание и контекст. Записать исправление и цитировать исходный фрагмент: общая близость слов не гарантирует сохранения смысла.
Подробные практические руководства
Перейти от скана к проверенной информации: проверить символы, таблицы, порядок чтения и языки до поиска, расчётов и цитирования распознанного текста.
Обновление :
Иллюстрация, созданная ИИ
Выделяемый текст может скрывать потерянное отрицание, заменённую цифру, смешанные колонки или разорванное имя. OCR облегчает поиск, но исходная страница остаётся основой проверки. Нужно различать извлечение для нахождения фрагмента и достаточно надёжное извлечение для цитаты или расчёта. Универсальный процент точности не заменяет оценку конкретного использования.
Записать документ, происхождение, дату получения и нумерацию страниц. Хранить изображение и текст отдельно с обозначением версий. Новое распознавание не должно перезаписывать уже использованное доказательство. Проверить условия доступа и повторного использования.
Включить простую страницу, таблицу, примечание, узкую колонку и реально присутствующие письменности. Добавить все значимые суммы, даты, единицы, имена и отрицания. Только лёгкие страницы плохо представляют неоднородный корпус; указать охват.
Читать изображение и текст рядом. Проверить ноль и O, единицу и I, десятичные разделители, минусы и ссылки. Рассматривать числа с единицами и периодами. Отмечать исправления в транскрипции, не меняя исходник незаметно.
Проследить заголовки, абзацы, колонки, примечания и ячейки. Строка таблицы не просто набор слов: связать значения с заголовками. Проверить продолжения таблиц на других страницах. Для каждого используемого значения сохранить страницу или область источника.
Искать имя, ссылку и выражение в каждой письменности. Проверить диакритику, арабские символы, пунктуацию и смешанные строки. Распознавание знаков отличается от перевода смысла. Не исправлять собственные имена автоматически общим словарём.
Разделить фрагменты на проверенные, исправленные с записью и ненадёжные. Частичный OCR может помогать поиску, оставаясь непригодным для расчёта. Перечитать цитируемый фрагмент по источнику и дать устойчивый указатель. При смене движка повторить сложные страницы, а не только сравнить общий объём.
Практикум чтения данных
Пример DEMO-O12 разделяет совпадение символов и порядок блоков перед цитированием или соединением.
Вымышленные данные и записи для обучения: результаты не получены запросами к действующим сервисам.
Страницу следует читать сначала по левой, затем по правой колонке. OCR чередует блоки и заменяет два нуля кода буквами O; совпадение символов не учитывает этот дефект порядка.
Если таблица шире экрана, прокрутите её по горизонтали; стрелки работают, когда область в фокусе.
| Этап | Данные примера | Диагноз | Решение |
|---|---|---|---|
| Изображение с двумя колонками | Слева A1,A2; справа B1,B2 | Ожидаемый порядок A1,A2,B1,B2. | Сохранить изображение и координаты зон. |
| Исходный OCR | A1,B1,A2,B2 | Колонки чередуются и смешивают смысл. | Восстановить порядок по изображению. |
| Решающий идентификатор | Изображение AB-0010; OCR AB-OO10 | Два нуля стали буквами O. | Исправить с записью до использования. |
| Выборка выровненных символов | 2 ошибки на 10 000; совпадение 99,98 % | Вымышленный показатель не измеряет порядок блоков. | Перечитать каждый ключ, поддерживающий вывод. |
Раскройте каждый вариант и сравните разбор. Дополнительные проверки могут оставаться необходимыми.
Нет: двух ошибок достаточно для изменения ключа.
Нет: структура и символы проверяются отдельно.
Подходит. Проверить весь фрагмент; хранить исходный текст отдельно от исправленной транскрипции.
Дело: DEMO-O12
Изображение: AB-0010; исходный OCR: AB-OO10
Исходный порядок: A1,B1,A2,B2
Проверенный порядок: A1,A2,B1,B2
Выборка: 10 000 символов; ошибок: 2
Исправление: код и порядок со ссылкой на страницу
Использование: только проверенный фрагмент
Привяжите цитату к проверенной странице и области изображения. Храните отдельно исходный OCR, исправленную транскрипцию и основание каждого исправления кода.
Распознанный текст разрешает то, что оригинал исключает. Сравнить всю фразу, примечание и контекст. Записать исправление и цитировать исходный фрагмент: общая близость слов не гарантирует сохранения смысла.
Заголовки находятся, но абзацы чередуются между колонками. Восстановить порядок по изображению до пересказа. Поиск полной фразы покажет, принадлежат ли слова одному фрагменту.
Значение потеряло знак или попало в другую колонку. Проверить все используемые ячейки, заголовки и единицы. Считать только по проверенным значениям, отмечая нечитаемые ячейки вместо догадок.
Разбор фрагмента
В вымышленном упражнении A передаёт значение, прочитанное на исходном изображении, а B — результат OCR. Страница и таблица позволяют вернуться к нужной области.
Вымышленное упражнение: идентификаторы, значения и даты иллюстрируют проверку. Это не ответ, полученный в реальном времени.
Связать страницу 7, таблицу 2, заголовок и единицу EUR. Не проверять число без контекста.
В A есть десятичная запятая и пробел группировки. B потерял их; 125000 не равно 1 250,00.
Сохранить исходный вывод и отдельную правку со ссылкой на ячейку. Пересчитать результаты с неверным масштабом.
p. 7 / table 2
A   1 250,00 EUR
B 125000 EURНет. Правила записи и ошибки могут различаться по столбцам и страницам. Каждую существенную правку обосновывают исходной областью; слепое общее правило может создать новые ошибки.
Официальные источники : Tesseract — Improving the quality of the output
ЧТЕНИЕ / РАЗБОР ПРИМЕРА
Сравниваются две вымышленные строки с сохранением регистра, знаков и всех трёх пробелов. Эталон содержит 18 символов ASCII и четыре токена. Здесь токены разделяются пробелами с сохранением пунктуации: это явно выбранное правило WER, а не универсальная настройка.
Вымышленный пример · это не наблюдения сервиса или клиента.
На небольшом экране прокручивайте таблицу по горизонтали.
| Проверка | Значение примера | Трактовка |
|---|---|---|
| Проверенный эталон | REF A01 -12.50 EUR | 18 символов с пробелами; четыре токена. |
| Исходный результат OCR | REF A0I 12.50 EUR | 17 символов; цифра 1 стала I, знак минус исчез. |
| CER: ошибки символов | 2 / 18 × 100 ≈ 11.1 % | Одна замена и одно удаление относительно числа символов эталона. |
| WER: правило этого примера | 2 / 4 × 100 = 50 % | Заменены два токена из четырёх: идентификатор и сумма со знаком. |
| Пригодность к использованию | A01 ≠ A0I ; -12.50 ≠ 12.50 | Идентификатор может указывать на другой объект, а знак меняет значение на противоположное. Перед сопоставлением или расчётом вернуться к областям источника. |
Дополнение CER не измеряет истинность документа или вероятность верности каждого поля. Здесь оба нужных поля изменены, хотя строки похожи.
Удаление пунктуации перед расчётом может скрыть потерю минуса. Сравнивать результаты по одинаковым правилам, а важные поля и порядок чтения проверять отдельно.
Источники просмотрены
Упражнение с разбором
Вымышленный пример: значения и документы служат для изучения метода и не описывают реальную организацию.
Столбец показывает изменение в процентах. Автоматическое резюме называет его ростом.
Если таблица шире экрана, прокрутите её по горизонтали; стрелки работают, когда область в фокусе.
| Источник | Прочитанный текст |
|---|---|
| Изображение таблицы | −12,5 |
| Результат OCR | 12.5 |
Значение −12,5 % означает снижение в этой таблице. Замена запятой точкой может быть форматированием; потеря знака меняет смысл. Исправить также резюме и производные расчёты, сохранив идентифицируемый исходный OCR.
Если тире может быть кодом пропуска, проверить легенду и расположение; не считать его автоматически минусом.
Сохранить страницу, положение ячейки, читаемое изображение, исходный OCR и обоснование исправления.
ДОКУМЕНТИРОВАННЫЕ ОРИЕНТИРЫ
ALTO 4.4 определяет WC для слов и CC для символов с противоположными концами шкал. Это метаданные OCR, не измеренная точность вашего корпуса.
| Ориентир | Значение или форма | Что обозначает |
|---|---|---|
| WC | 0 → 1 | 0 — неуверенно, 1 — уверенно по оценке движка; высокий балл не заменяет чтения изображения. |
| CC | 0 → 9 | Число для каждого символа: 0 — уверенно, 9 — неуверенно. Не считайте 9 большей уверенностью. |
| HPOS / VPOS | MeasurementUnit | Горизонтальная и вертикальная позиции в объявленных единицах; не предполагайте пиксели. |
| CONTENT | String | Распознанное содержимое текстовой единицы; сохраняйте связь со страницей и областью. |
| ReadingOrder | ALTO 4.3+ | Явный порядок чтения введён в 4.3; проверьте версию до поиска элемента. |
Сохраняйте версию, единицу, текст и координаты вместе. Институциональные профили различаются; BnF описывает варианты ALTO. Отсутствующий балл не равен нулевой уверенности.
Нет. WC — уверенность движка для текстовой единицы, не наблюдённая точность символов. Сравнивайте фрагменты с эталонной транскрипцией и описывайте выборку, не превращая балл в сертификат.
Документация просмотрена .
ДОКУМЕНТИРОВАННЫЕ ОРИЕНТИРЫ
Репродукция показывает разворот экземпляра Библии Гутенберга из Библиотеки Конгресса с владельческими знаками на внутренней стороне переплёта. Источник — WDL7782 через Wikimedia Commons. Разделяйте произведение и историю экземпляра.
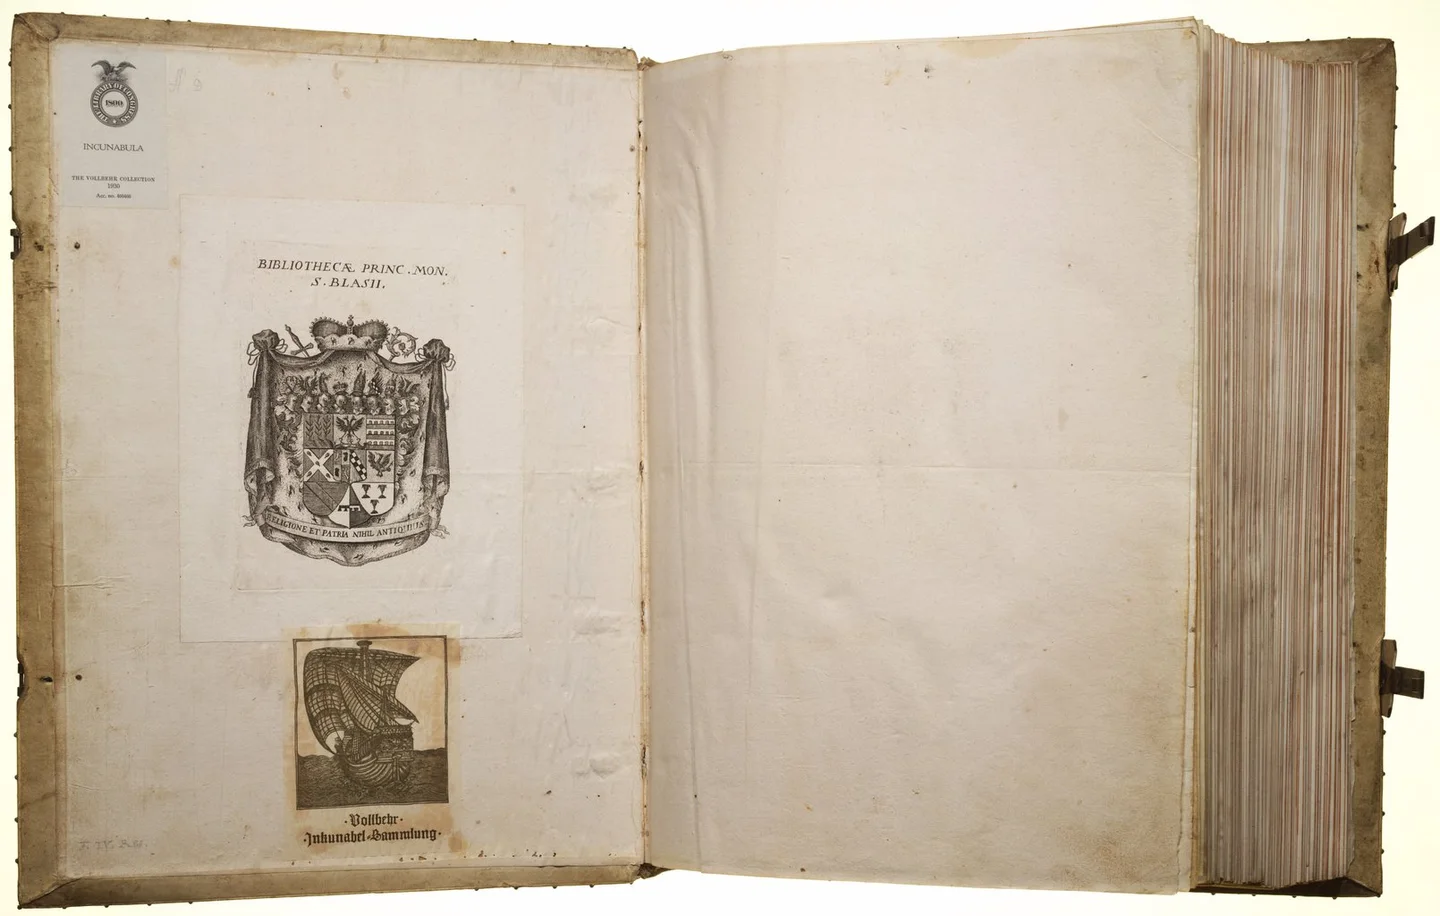
Разворот Библии Гутенберга из Библиотеки Конгресса: внутренняя сторона переплёта с экслибрисами, этикеткой коллекции Фолльбера 1930 года и форзацем.
Подлинная документальная репродукция · Library of Congress · World Digital Library · Wikimedia Commons · Источник · Использование
Репродукция отмечена в записи как общественное достояние. Уменьшена и переведена в WebP без обрезки. Дата съёмки не указана.
| Ориентир | Значение или форма | Что обозначает |
|---|---|---|
| Biblia latina | Mainz · c. 1455 | Выставка библиотеки относит печать к Майнцу, вероятно с завершением в конце 1455 года. |
| Language | Латинский | Текст латинской Вульгаты; язык коллекционной этикетки не равен языку всей книги. |
| Material | Велен | Этот экземпляр напечатан на велене согласно описанию учреждения. |
| Vollbehr | 1930 | Год приобретения коллекции Фолльбера библиотекой; виден также на коллекционной этикетке репродукции. |
| WDL | 7782 | Идентификатор записи World Digital Library в происхождении файла, не номер страницы. |
В OCR отделяйте текст, пометы, экслибрисы и добавленные этикетки. Привязывайте сведения к области и функции. Дата оцифровки или съёмки здесь не указана; не выводите её из 1455 или 1930 года.
Это коллекционная метка, не год печати. Описание учреждения отдельно подтверждает приобретение в 1930 году. Сохраняйте различие и точный экземпляр: его знак не описывает все экземпляры издания.
Документация просмотрена .
ДОКУМЕНТИРОВАННЫЕ ОРИЕНТИРЫ
Части ISO 19005 задают требования сохранения отображения и ресурсов. Таблица сравнивает документированные профили, а не результаты проверки файлов посетителя. Сначала определите точный профиль.
| Ориентир | Значение или форма | Что обозначает |
|---|---|---|
| PDF/A-1 | ISO 19005-1:2005 | Первая часть на основе PDF 1.4. Поддерживает воспроизводимость отображения; расширение .pdf не доказывает соответствие. |
| PDF/A-2 | ISO 19005-2:2011 | Основана на PDF 1.7, разрешает дополнительные функции и вложение PDF/A по своим правилам. Это не разрешение любых форматов вложений. |
| PDF/A-3 | ISO 19005-3:2012 | Позволяет вложения любого формата. Соответствие контейнера не делает вложения сохраняемыми, доступными или соответствующими PDF/A. |
| PDF/A-4f | ISO 19005-4:2020 | Профиль части 4 на основе PDF 2.0 с вложениями других форматов. Название не раскрывает их природу или качество. |
| pdfaid:part / pdfaid:conformance | 1 / B | Пример XMP для PDF/A-1b: part равен 1, conformance — B. Метаданные заявляют соответствие, а не успешную проверку. |
| PDF/UA | ISO 14289 | Семейство стандартов доступности PDF. Возможно одновременное соответствие PDF/A и PDF/UA; одного PDF/A недостаточно. |
Храните точный файл, профиль, средство и версию, правила и результаты. OCR, порядок чтения, вложения и подписи требуют отдельных проверок. Формат не удостоверяет автора, дату или утверждения.
Нет. Выделение не доказывает семантическую структуру, порядок чтения или описания изображений. Проверяйте требования и чтение вспомогательными средствами.
Документация просмотрена .
Она помогает выбрать приоритеты, но не заменяет сравнение решающих фрагментов. Одна ошибка способна перевернуть смысл.
Объём зависит от задачи. Для цитаты проверить фрагмент и контекст, для расчёта — все используемые ячейки.
Сравнить новое извлечение на тех же фрагментах. Сохранить исходное изображение и записать преобразования, отделив источник от подготовленных файлов.
Нет. Распознавание и перевод — разные этапы с разными ошибками. Сохранить фрагмент на языке источника.
Цифры, имена, даты и резервы, от которых зависит заключение. Значительная ошибка может обосновать рассмотрение таблиц или пунктов, произведенных одним и тем же процессом распознавания.
ДОКУМЕНТИРОВАННЫЕ ОРИЕНТИРЫ
Расстояние Левенштейна считает минимальные операции превращения эталона в проверяемый текст. Оно помогает проверить транскрипцию или фрагмент, но не верность перевода или истинность ответа.
| Ориентир | Значение или форма | Что обозначает |
|---|---|---|
| S / D / I | reference → candidate | S заменяет единицу эталона, D удаляет её, I добавляет единицу в кандидат. Каждая операция стоит 1; перестановка букв не является отдельной операцией. |
| N / M | H+S+D / H+S+I | N — длина эталона после заданной обработки. При H совпадениях N = H + S + D, длина кандидата — H + S + I. |
| CER / WER (%) | 100 × (S+D+I) / N | Процент ошибок равен 100 × (S + D + I) / N и может превышать 100 %: для a и aaa нужны две вставки на одну эталонную единицу. |
| units / profile | code points · White_Space 17.0.0 · raw / NFC | Символьный режим считает кодовые точки, не графемы или UTF-16. Словесный делит по 25 символам White_Space Unicode 17.0.0 без языкового анализа. Регистр и пунктуация сохраняются; NFC необязателен. |
| tie-break | H → S → D → I | Минимальных выравниваний может быть несколько. Обратный проход выбирает H, затем S, D, I. Для ab и ba выбираются две замены; удаление со вставкой могут дать ту же стоимость. |
| N = 0 | undefined rate | При N = 0 операции показываются, а доля не определена, даже для двух пустых текстов. JiWER 4 задаёт другие соглашения: сравнивайте одинаковые профили. |
Авторский учебный пример, не измерение реального OCR.
До 200 кодовых точек в тексте до и после NFC. Регистр и пунктуация сохраняются. Переводы строк LF.
Вычисления в браузере без передачи введённых текстов.
Сравнение вычислено · WER · raw · N = 3 · E = 1
Замены S : 0Удаления D : 0Вставки I : 1Совпадения H : 3
Пустой эталон: операции считаются, локальная доля не определена.
Минимальная стоимость и приоритет H, S, D, I при обратном проходе. Другие оптимумы могут иначе распределять ошибки.
∅ — отсутствие единицы. Запись JSON показывает пробелы и переводы строк.
Первые 100 шагов; счётчики учитывают всё выравнивание.
| Шаг | Единица эталона | Единица кандидата | Операция |
|---|---|---|---|
| 1 | "le" | "le" | Совпадения H |
| 2 | "chat" | "chat" | Совпадения H |
| 3 | ∅ | "noir" | Вставки I |
| 4 | "dort" | "dort" | Совпадения H |
{"reference":"le chat dort","candidate":"le chat noir dort"}N = H + S + D; M = H + S + I E = S + D + I N > 0 → rate = 100 × E/N N = 0 → undefined
Примеры записаны в JSON с Unicode-экранированием; оно не определяет единицу счёта.
| Проверенный эталонный текст | Проверяемый текст | Формула и профиль | N | E | Доля ошибок (%) |
|---|---|---|---|---|---|
| "le chat dort" | "le chat noir dort" | WER · raw | 3 | 1 | 33,333333 |
| "le chat dort" | "le chat noir dort" | CER · raw | 12 | 5 | 41,666667 |
| "a" | "aaa" | CER · raw | 1 | 2 | 200 |
| "cat" | "" | CER · raw | 3 | 3 | 100 |
| "" | "x" | CER · raw | 0 | 1 | Не определено |
| "" | "" | CER · raw | 0 | 0 | Не определено |
| "ab" | "ba" | CER · raw | 2 | 2 | 100 |
| "\u00e9" | "e\u0301" | CER · raw | 1 | 2 | 200 |
| "\u00e9" | "e\u0301" | CER · NFC | 1 | 0 | 0 |
| "Le chat." | "le chat" | WER · raw | 2 | 2 | 100 |
| "les chats" | "les chats" | WER · raw | 2 | 0 | 0 |
| "les chats" | "les chats" | CER · raw | 10 | 1 | 10 |
| "un\u00a0chat" | "un chat" | WER · raw | 2 | 0 | 0 |
| "\u6587\u672c" | "\u6587\u4f53" | WER · raw | 1 | 1 | 100 |
| "\u6587\u672c" | "\u6587\u4f53" | CER · raw | 2 | 1 | 50 |
| "\u0634\u064e" | "\u0634" | CER · raw | 2 | 1 | 50 |
| "\ud83e\udded" | "\ud83e\udded\ud83e\udded" | CER · raw | 1 | 1 | 100 |
| "un\u200bchat" | "un chat" | WER · raw | 1 | 2 | 200 |
White_Space фиксирован по Unicode 17.0.0; NFC использует движок браузера. Акценты, регистр и пунктуация не удаляются.
White_Space data from PropList-17.0.0.txt. Copyright © 2025 Unicode, Inc.

UNICODE LICENSE V3

COPYRIGHT AND PERMISSION NOTICE

Copyright © 1991-2026 Unicode, Inc.

NOTICE TO USER: Carefully read the following legal agreement. BY
DOWNLOADING, INSTALLING, COPYING OR OTHERWISE USING DATA FILES, AND/OR
SOFTWARE, YOU UNEQUIVOCALLY ACCEPT, AND AGREE TO BE BOUND BY, ALL OF THE
TERMS AND CONDITIONS OF THIS AGREEMENT. IF YOU DO NOT AGREE, DO NOT
DOWNLOAD, INSTALL, COPY, DISTRIBUTE OR USE THE DATA FILES OR SOFTWARE.

Permission is hereby granted, free of charge, to any person obtaining a
copy of data files and any associated documentation (the "Data Files") or
software and any associated documentation (the "Software") to deal in the
Data Files or Software without restriction, including without limitation
the rights to use, copy, modify, merge, publish, distribute, and/or sell
copies of the Data Files or Software, and to permit persons to whom the
Data Files or Software are furnished to do so, provided that either (a)
this copyright and permission notice appear with all copies of the Data
Files or Software, or (b) this copyright and permission notice appear in
associated Documentation.

THE DATA FILES AND SOFTWARE ARE PROVIDED "AS IS", WITHOUT WARRANTY OF ANY
KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF
MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT OF
THIRD PARTY RIGHTS.

IN NO EVENT SHALL THE COPYRIGHT HOLDER OR HOLDERS INCLUDED IN THIS NOTICE
BE LIABLE FOR ANY CLAIM, OR ANY SPECIAL INDIRECT OR CONSEQUENTIAL DAMAGES,
OR ANY DAMAGES WHATSOEVER RESULTING FROM LOSS OF USE, DATA OR PROFITS,
WHETHER IN AN ACTION OF CONTRACT, NEGLIGENCE OR OTHER TORTIOUS ACTION,
ARISING OUT OF OR IN CONNECTION WITH THE USE OR PERFORMANCE OF THE DATA
FILES OR SOFTWARE.

Except as contained in this notice, the name of a copyright holder shall
not be used in advertising or otherwise to promote the sale, use or other
dealings in these Data Files or Software without prior written
authorization of the copyright holder.
Авторские примеры, не измерения программ. Малая доля не гарантирует порядок чтения или правильность имён и сумм. Проверяйте сам эталон по документу. Браузер приводит переводы строк к LF.
Уверенность — оценка самого движка. CER или WER сравнивает результат с выбранным эталоном по заданному профилю. Сохраняйте обе величины с методиками; они не заменяют проверки важного фрагмента.
Документация просмотрена .
ПОДРОБНЕЕ / ПРАКТИКА
Дигитальный документ был конвертирован в текст. Контроль должен сосредоточиться на названиях, датах, цифрах и резервах, которые влияют на чтение, а затем сравнивать с визуальным документом.
Обновлено .
Рассмотрим перечисленные параграфы, таблицы и разрывы страницы. Отмечают заблуждения знаков, слитые линии и заметки, порядок которых был изменен.
Течный текст может содержать значительную цифровую ошибку. В поисках полного текста может отсутствовать неправильно распознаваемое имя или слово.
Журнал OCR сочетает перевод, признанный текст, проверенное чтение и коррекцию. Экстракты, используемые в заключении, связаны с их местоположением в оригинальном документе.