Contrôler une extraction OCR avant de citer un document
Passer d’une page numérisée à une information vérifiée : contrôler caractères, tableaux, ordre de lecture et langues avant de rechercher, calculer ou citer un texte reconnu automatiquement.
Mise à jour :
Illustration générée par IA
Le texte extrait conserve-t-il le sens du document ?
Un texte sélectionnable peut contenir des erreurs invisibles à la première lecture : négation perdue, chiffre remplacé, colonne mélangée ou nom coupé. L’OCR facilite la recherche, mais la page source reste le point de contrôle. La recette distingue l’extraction utilisable pour retrouver un passage de celle assez fiable pour alimenter une citation ou un calcul. Aucun taux universel ne remplace ce jugement lié à l’usage.
Conserver la source
Noter document, provenance, date de récupération et pagination. Garder la page image et le texte extrait séparément, avec leurs versions. Une nouvelle extraction ne doit pas écraser la preuve utilisée précédemment. Vérifier que l’accès et la réutilisation du document correspondent au travail prévu.
Choisir les passages à contrôler
Inclure une page simple, un tableau, une note, une colonne serrée et les écritures réellement présentes. Ajouter toutes les valeurs qui soutiennent la conclusion : montants, dates, unités, noms et négations. Un échantillon de pages faciles décrit mal un corpus hétérogène ; préciser la couverture retenue.
Comparer les caractères décisifs
Lire image et extraction côte à côte. Vérifier zéro et lettre O, un et lettre I, séparateurs décimaux, signes moins et références. Contrôler les nombres dans leur unité et leur période. Une correction doit être signalée dans la transcription, sans transformer silencieusement le fichier source.
Reconstituer la structure
Suivre titres, paragraphes, colonnes, notes et cellules. Une ligne de tableau n’est pas une simple suite de mots : rattacher chaque valeur à son en-tête. Vérifier les tableaux répartis sur plusieurs pages. Conserver la page ou la zone d’origine pour chaque donnée réutilisée.
Tester la recherche et les langues
Chercher un nom, une référence et une expression dans chaque écriture. Examiner accents, caractères arabes, ponctuation et ordre des chaînes mixtes. Distinguer l’OCR, qui reconnaît des signes, de la traduction, qui reformule le sens. Ne pas corriger automatiquement un nom propre avec un dictionnaire général.
Décider de l’usage
Classer les passages comme contrôlés, corrigés avec trace ou non fiables. Une extraction partielle peut aider à retrouver une page tout en étant exclue d’un calcul. Relire directement les passages cités et joindre un repère stable. Après changement de moteur ou réglage, rejouer les passages difficiles, pas seulement le volume total.
Atelier de lecture
Un bon score ne valide pas l’identifiant
Le cas DEMO-O12 sépare accord des caractères et ordre des blocs avant une citation ou une jointure.
Données et traces fictives pour apprendre : aucun résultat présenté ici ne provient d’un service interrogé en direct.
Ordre des colonnes et identité d’un code
La page doit se lire colonne gauche puis colonne droite. Le texte OCR alterne les blocs et remplace deux zéros du code par des lettres O ; le score de caractères ne couvre pas ce défaut d’ordre.
Si le tableau dépasse l’écran, faites-le défiler horizontalement ; les flèches du clavier fonctionnent lorsque la zone est sélectionnée.
Ordre des colonnes et identité d’un code
Étape
Donnée du cas
Diagnostic
Décision
Image à deux colonnes
Gauche A1,A2 ; droite B1,B2
Ordre attendu A1,A2,B1,B2.
Conserver image et repères de zones.
Extraction brute
A1,B1,A2,B2
Les colonnes alternent et mélangent le raisonnement.
Reconstituer l’ordre par lecture de l’image.
Identifiant décisif
Image AB-0010 ; OCR AB-OO10
Deux zéros deviennent des lettres O.
Corriger avec trace avant réutilisation.
Échantillon aligné de caractères
2 erreurs sur 10 000 ; accord 99,98 %
Ce score fictif ne mesure pas l’ordre des blocs.
Relire tous les identifiants soutenant la conclusion.
Peut-on citer AB-OO10 grâce aux 99,98 % ?
Ouvrir chaque proposition pour comparer son diagnostic. Plusieurs contrôles peuvent rester nécessaires.
Oui, le score est presque parfait.
Non : deux erreurs suffisent à changer la clé utilisée.
Oui, après remise en ordre des colonnes.
Non : structure et caractères sont deux contrôles distincts.
Non ; relire le code sur l’image et tracer la correction.
Adapté. Vérifier aussi le passage complet ; conserver séparément texte brut et transcription corrigée.
Joindre au passage cité la page et la zone d’image relues. Conserver séparément l’extraction brute, la transcription corrigée et la justification de chaque correction du code.
Documentation des règles, distincte des exemples fictifs
Le texte extrait affirme une possibilité que la page imprimée exclut. Comparer la phrase complète, sa note et son contexte. Corriger la transcription avec une trace et revenir à la source dans la citation ; une ressemblance globale des mots ne protège pas le sens.
Deux colonnes fusionnent
Les titres sont retrouvés, mais les paragraphes alternent entre colonnes. Reconstituer l’ordre sur l’image avant de résumer. Tester ensuite une requête portant sur une phrase complète : la présence des mots dans l’index ne prouve pas qu’ils appartiennent au même passage.
Un total semble incohérent
Une valeur a perdu son signe ou changé de colonne. Vérifier chaque cellule utile, ses en-têtes et son unité. Recalculer uniquement depuis les valeurs contrôlées ; documenter les cellules illisibles plutôt que les compléter par intuition.
Lecture guidée d’un extrait
Un séparateur perdu multiplie un montant par cent
Dans cet exercice fictif, A transcrit la valeur lue sur l’image source et B le résultat OCR. La page et le tableau sont indiqués pour pouvoir revenir à la bonne zone.
Exercice fictif : les identifiants, valeurs et dates illustrent le contrôle. Cet extrait n’est pas une réponse collectée en direct.
01
Retrouver la cellule
Relier page 7, tableau 2, en-tête et unité EUR. Ne pas contrôler le nombre sans son contexte.
02
Comparer les caractères
A contient une virgule décimale et un espace de groupement. B les a perdus ; 125000 ne signifie pas 1 250,00.
03
Corriger la transcription
Conserver le résultat brut et une correction distincte reliée à la cellule. Refaire les calculs qui ont utilisé la mauvaise échelle.
Comparaison fictive : A = lecture de l’image ; B = OCR
p. 7 / table 2
A   1 250,00 EUR
B   125000 EUR
Ce qu’il faut examiner
Valeur retenue : 1 250,00 EUR
Le chiffre brut 125000 EUR serait cent fois plus grand.
Portée du contrôle
Une cellule vérifiée ne valide ni tout le tableau ni toutes les pages. Contrôler aussi les négations, noms et unités décisifs.
Ajouter une virgule à tous les nombres OCR constitue-t-il une correction fiable ?
Raisonnement
Non. Les conventions et les erreurs peuvent varier selon la colonne ou la page. Chaque correction déterminante doit être justifiée par la zone source ; une règle globale aveugle peut créer de nouvelles erreurs.
Deux erreurs de caractères, deux champs décisifs à reprendre
On compare deux chaînes fictives en conservant les majuscules, les signes et les trois espaces. La référence contient 18 caractères ASCII et quatre jetons. Pour cet exemple, les jetons sont séparés par les espaces, sans retirer la ponctuation : c’est la convention déclarée du WER ci-dessous, pas un réglage universel.
Exemple fictif · aucune observation d’un service ou d’un client.
Sur petit écran, faites défiler le tableau horizontalement.
Deux erreurs de caractères, deux champs décisifs à reprendre
Contrôle
Valeur de l’exemple
Interprétation
Référence relue
REF A01 -12.50 EUR
18 caractères, espaces compris ; quatre jetons.
Sortie OCR brute
REF A0I 12.50 EUR
17 caractères ; le chiffre 1 est devenu I et le signe moins a disparu.
CER : erreurs de caractères
2 / 18 × 100 ≈ 11.1 %
Une substitution et une suppression, rapportées aux caractères de la référence.
WER : convention de cet exemple
2 / 4 × 100 = 50 %
Deux jetons remplacés sur quatre : l’identifiant et le montant signé.
Contrôle de l’usage
A01 ≠ A0I ; -12.50 ≠ 12.50
L’identifiant peut viser un autre objet, et le signe inverse la valeur. Revenir aux zones source avant rapprochement ou calcul.
Peut-on annoncer une fiabilité de 88,9 % ?
Ce complément du CER ne mesure ni la vérité du document ni la probabilité que chaque champ soit juste. Ici, les deux champs utiles sont altérés malgré la proximité des chaînes.
Pourquoi documenter les conventions ?
Retirer la ponctuation avant le calcul pourrait effacer l’erreur de signe. Comparer les extractions avec les mêmes règles, puis examiner séparément les champs décisifs et l’ordre de lecture.
Exemple fictif : les valeurs et documents servent à apprendre la méthode, sans décrire un organisme réel.
La colonne représente une variation en pourcentage. Le résumé automatique parle d’une hausse.
Si le tableau dépasse l’écran, faites-le défiler horizontalement ; les flèches du clavier fonctionnent lorsque la zone est sélectionnée.
Données de départ
Source
Texte lu
Image du tableau
−12,5
Extraction OCR
12.5
À vous de vérifier
Relire la cellule sur l’image originale.
Vérifier signe, séparateur et en-tête.
Recalculer la conclusion à partir de la cellule corrigée.
Lire le corrigé
Corrigé et décision
La valeur est −12,5 %, donc une baisse dans ce tableau. Le changement de virgule à point peut être une normalisation de format ; la disparition du signe change le sens. Corriger aussi le résumé et les calculs dérivés, en gardant l’extraction initiale identifiable.
Si le cas change
Si le tiret peut être un code de valeur manquante, lire la légende et l’alignement ; ne pas lui attribuer automatiquement le rôle de signe négatif.
Trace à conserver
Garder page, coordonnées de cellule, image lisible, texte OCR brut et correction motivée.
REPÈRES DOCUMENTÉS
ALTO : deux échelles de confiance qui ne vont pas dans le même sens
Dans le schéma ALTO 4.4, WC décrit la confiance d’un mot et CC celle des caractères. Les extrémités de leurs échelles sont opposées. Le schéma décrit des métadonnées OCR ; il ne donne pas un taux d’exactitude mesuré sur votre corpus.
ALTO : deux échelles de confiance qui ne vont pas dans le même sens
Repère
Valeur ou forme
Ce que cela désigne
WC
0 → 1
De 0, incertain, à 1, sûr selon le moteur ; un score élevé ne remplace pas une lecture de l’image.
CC
0 → 9
Un nombre par caractère : 0 signifie sûr et 9 incertain. Ne pas lire 9 comme une meilleure confiance.
HPOS / VPOS
MeasurementUnit
Positions horizontale et verticale à interpréter dans l’unité déclarée ; ne pas présumer des pixels.
CONTENT
String
Contenu reconnu d’une unité textuelle ; garder son lien à la page et à la zone.
ReadingOrder
ALTO 4.3+
Ordre de lecture explicite introduit en version 4.3 ; contrôler la version avant d’attendre cet élément.
À retenir pour le dossier
Conservez version, unité, texte et coordonnées ensemble. Les profils institutionnels peuvent différer du schéma général : la BnF signale notamment ses variantes ALTO. Une case vide ou un score absent n’est pas une confiance nulle.
Peut-on publier « WC = 0,99, donc 99 % de caractères exacts » ?
Non. WC est une confiance du moteur pour une unité textuelle, pas une mesure observée du taux de caractères corrects. Pour évaluer une extraction, comparez des passages à une transcription de référence et décrivez l’échantillon, sans transformer le score en certification.
Une marque de 1930 ne date pas l’impression du livre
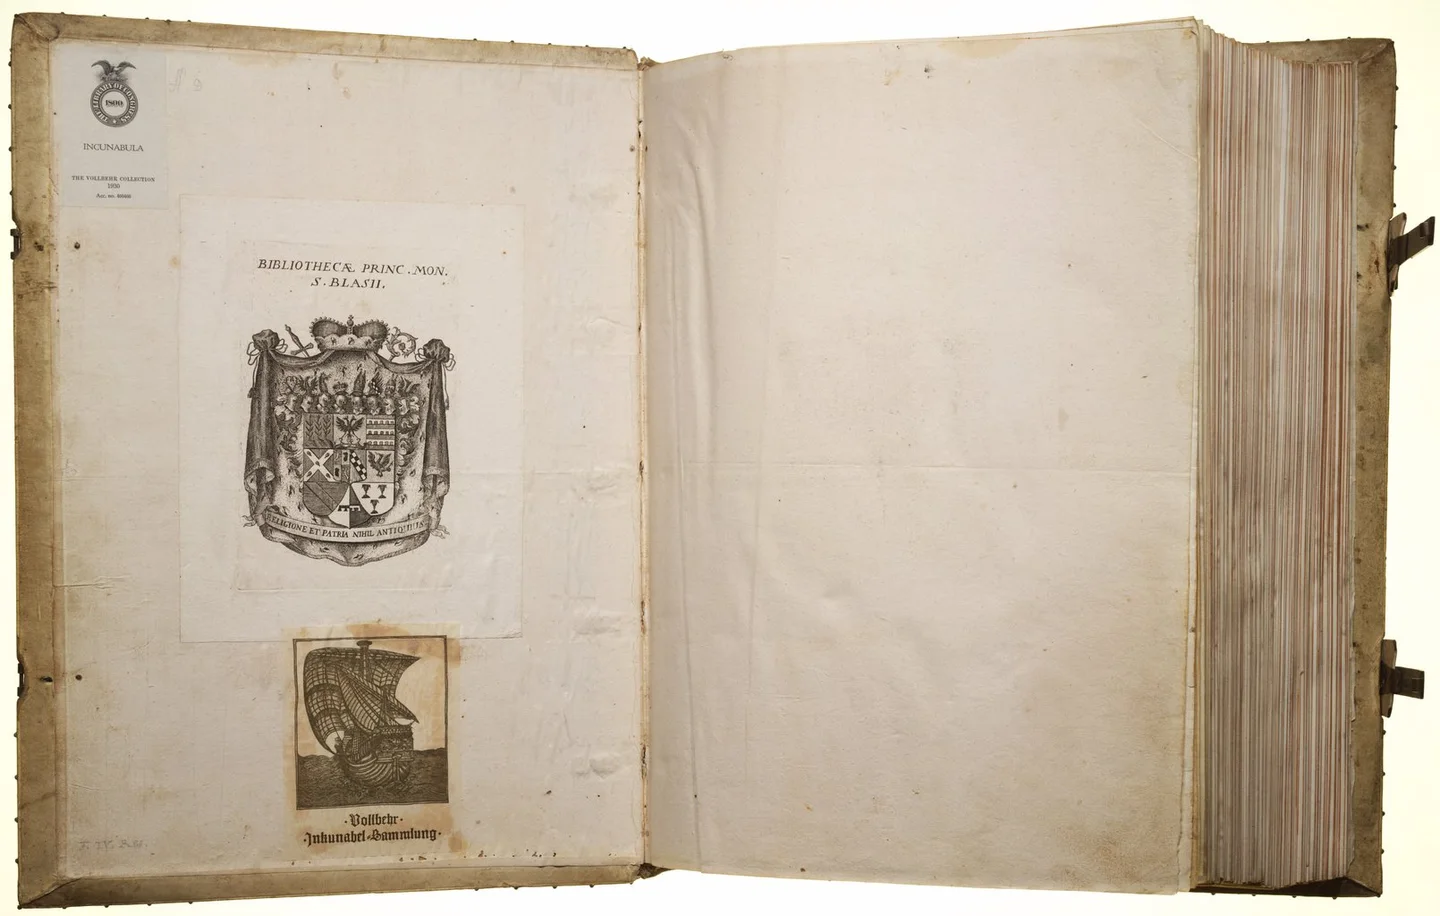
Cette reproduction montre une ouverture de l’exemplaire de la Bible de Gutenberg conservé à la Library of Congress, avec des marques de provenance sur le contreplat. Elle provient du fichier WDL7782 relayé par Wikimedia Commons. L’ouvrage et l’histoire de cet exemplaire doivent être décrits séparément.
Ouverture de l’exemplaire de la Bible de Gutenberg conservé à la Library of Congress : contreplat avec ex-libris, étiquette de la collection Vollbehr datée de 1930 et feuillet de garde.
Reproduction documentaire réelle · Library of Congress · World Digital Library · Wikimedia Commons · Source · Réutilisation
Reproduction d’un ouvrage ancien signalée dans le domaine public sur la fiche du fichier. Réduction et conversion WebP sans recadrage. Date de prise de vue non précisée.
Une marque de 1930 ne date pas l’impression du livre
Repère
Valeur ou forme
Ce que cela désigne
Biblia latina
Mainz · c. 1455
L’exposition de la Library of Congress situe l’impression à Mayence, probablement achevée vers la fin de 1455.
Language
Latin
Texte de la Bible en latin, dans la traduction dite Vulgate ; la langue d’une étiquette de collection n’est pas celle de tout l’ouvrage.
Material
Vélin
Cet exemplaire est imprimé sur vélin, selon la description institutionnelle.
Vollbehr
1930
Année de l’acquisition de la collection Vollbehr par la Library of Congress, également visible dans l’étiquette de collection de la reproduction.
WDL
7782
Identifiant de la notice World Digital Library citée dans la provenance du fichier ; ce n’est pas une pagination.
À retenir pour le dossier
Lors d’un OCR, distinguez le texte de l’œuvre, les annotations, les ex-libris et les étiquettes ajoutées. Attribuez chaque information à sa zone et à sa fonction. La date de numérisation ou de prise de vue n’est pas donnée ici ; elle ne doit pas être déduite de 1455 ou de 1930.
Que permet de lire la mention « The Vollbehr Collection 1930 » ?
Elle renseigne une marque de collection, pas l’année d’impression. La notice institutionnelle documente séparément l’acquisition en 1930. Une citation contrôlable garde cette distinction et l’exemplaire précis : une marque propre à ce volume ne décrit pas tous les exemplaires de la même édition.
PDF/A : un profil de conservation n’est pas un certificat d’authenticité
Les parties de la famille ISO 19005 décrivent des exigences de conservation du rendu et de ses ressources. Le tableau compare des profils documentés, pas les résultats d’un contrôle effectué sur les PDF du visiteur. Il faut identifier le profil exact avant de lire un rapport de conformité.
PDF/A : un profil de conservation n’est pas un certificat d’authenticité
Repère
Valeur ou forme
Ce que cela désigne
PDF/A-1
ISO 19005-1:2005
Première partie, fondée sur PDF 1.4. Ses exigences visent notamment la reproductibilité du rendu ; le seul suffixe .pdf ne révèle pas la conformité à ce profil.
PDF/A-2
ISO 19005-2:2011
Partie fondée sur PDF 1.7 qui autorise des fonctions supplémentaires et l’inclusion de fichiers PDF/A selon ses règles. Cette possibilité ne s’étend pas à n’importe quel format de pièce jointe.
PDF/A-3
ISO 19005-3:2012
Permet d’intégrer des fichiers de formats quelconques. La conformité du conteneur ne rend pas ces pièces jointes elles-mêmes pérennes, accessibles ou conformes à PDF/A.
PDF/A-4f
ISO 19005-4:2020
Profil de la partie 4, fondée sur PDF 2.0, permettant des fichiers intégrés d’autres formats. Ne pas déduire la nature ni la qualité d’une pièce jointe du seul nom du profil.
pdfaid:part / pdfaid:conformance
1 / B
Exemple de déclaration XMP pour PDF/A-1b : part vaut 1 et conformance vaut B. Lire ces métadonnées identifie une conformité revendiquée, pas une validation technique réussie.
PDF/UA
ISO 14289
Famille consacrée à l’accessibilité des PDF. Un fichier peut viser à la fois PDF/A et PDF/UA ; la conformité à PDF/A seule ne suffit pas à établir l’accessibilité.
À retenir pour le dossier
Conserver le fichier exact, profil testé, outil et version, règles appliquées et résultats. L’OCR, l’ordre de lecture, les pièces jointes et les signatures demandent leurs propres contrôles. Une conformité de format ne certifie ni l’auteur, ni la date de publication, ni les affirmations du document.
Un PDF/A contenant du texte sélectionnable est-il forcément accessible ?
Non. La sélection de texte ne démontre pas une structure sémantique, un ordre de lecture correct ou des descriptions d’images adaptées. Examiner les exigences d’accessibilité pertinentes et réaliser une lecture avec les outils d’assistance.
La négation, le signe, le séparateur décimal et le nom propre décisifs ont-ils été comparés directement à la page visible ?
Les cellules d’un tableau gardent-elles le bon en-tête et le bon ordre après copie dans l’outil de travail ?
La citation renvoie-t-elle à la page source et signale-t-elle toute correction, plutôt qu’au seul texte extrait ?
Questions fréquentes
Un score de confiance élevé suffit-il ?
Il peut aider à prioriser la relecture, mais ne remplace pas la comparaison des passages décisifs. Le sens d’une phrase peut changer avec une seule erreur.
Faut-il transcrire tout le document ?
Adapter le travail à la décision. Pour une citation précise, contrôler le passage et son contexte ; pour un calcul, vérifier toutes les cellules utilisées.
Peut-on améliorer le scan après extraction ?
Comparer de nouvelles extractions sur les mêmes passages. Conserver l’image initiale et tracer les transformations afin de distinguer la source des fichiers préparés.
L’OCR traduit-il un document ?
Non. La reconnaissance du texte et la traduction sont des étapes différentes, avec des erreurs et contrôles distincts. Conserver le passage dans sa langue source.
Quels passages contrôler en priorité ?
Les chiffres, noms, dates et réserves dont dépend la conclusion. Une erreur significative peut justifier l’examen des tableaux ou passages produits par le même procédé de reconnaissance.
REPÈRES DOCUMENTÉS
OCR : mesurer les erreurs avec une référence et un profil explicites
La distance de Levenshtein compte les opérations minimales pour transformer une référence en texte candidat. Elle permet d’examiner une transcription ou un extrait, mais ne juge pas la fidélité d’une traduction ni la vérité d’une réponse.
OCR : mesurer les erreurs avec une référence et un profil explicites
Repère
Valeur ou forme
Ce que cela désigne
S / D / I
reference → candidate
S remplace une unité de la référence ; D en supprime une ; I ajoute une unité dans le candidat. Chaque opération coûte 1. La transposition de deux lettres n’est pas une opération spéciale ici.
N / M
H+S+D / H+S+I
N est la longueur de la référence après le traitement déclaré. Avec H unités identiques, N = H + S + D ; la longueur du candidat est H + S + I.
CER / WER (%)
100 × (S+D+I) / N
Le taux en pourcentage vaut 100 × (S + D + I) / N. Il peut dépasser 100 % : a comparé à aaa nécessite deux insertions pour une seule unité de référence.
units / profile
code points · White_Space 17.0.0 · raw / NFC
Le mode caractère compte les points de code, pas les graphèmes ni UTF-16. Le mode mot découpe sur les 25 séparateurs White_Space d’Unicode 17.0.0, sans analyse linguistique. Casse et ponctuation sont conservées ; NFC est facultatif.
tie-break
H → S → D → I
Plusieurs alignements peuvent avoir le même coût. Le retour arrière privilégie H, puis S, D et I. Pour ab comparé à ba, deux substitutions sont retenues ; suppression et insertion peuvent donner le même coût.
N = 0
undefined rate
Si N = 0, cet explorateur affiche les opérations et laisse le taux indéfini, même si les deux textes sont vides. JiWER 4 définit d’autres conventions pour ces cas : comparer seulement des résultats au même contrat.
Comparer deux textes, unité par unité
Exemple pédagogique original ; aucune mesure d’un moteur OCR réel.
Maximum 200 points de code par texte, avant et après NFC. Casse et ponctuation conservées. Fins de ligne LF dans les champs.
Les outils calculent dans votre navigateur, sans transmettre les textes saisis.
Comparaison calculée · WER · raw · N = 3 · E = 1
Unités de référence N
3
Unités du candidat M
4
Distance E = S + D + I
1
Taux d’erreur (%)
33,333333
Substitutions S : 0Suppressions D : 0Insertions I : 1Unités identiques H : 3
Référence vide : les opérations sont comptées, mais le taux local est indéfini.
Alignement choisi : coût minimal, puis priorité H, S, D, I au retour arrière. D’autres alignements optimaux peuvent répartir différemment les erreurs.
Effectifs S, D, I et H. L’axe va de 0 au maximum de 1, N et M. Ce graphique montre des nombres d’unités, pas des pourcentages.Voir l’alignement et les opérations
∅ signifie absence d’unité. Les unités sont affichées en notation JSON pour rendre les espaces et retours à la ligne repérables.
Les 100 premières étapes sont affichées ; les compteurs incluent tout l’alignement.
Exemples originaux, sans performance mesurée d’un logiciel. Un faible taux ne garantit ni le bon ordre de lecture, ni l’exactitude d’un nom ou d’un montant. Le texte de référence doit lui-même être contrôlé sur le document. Les fins de ligne des champs sont ramenées à LF par le navigateur.
Pourquoi un score OCR et un taux d’erreur ne sont-ils pas interchangeables ?
La confiance publiée par le moteur décrit sa propre estimation. CER ou WER compare un résultat avec une référence choisie et un profil de calcul. Conserver les deux informations avec leurs méthodes ; ni l’une ni l’autre ne remplace la vérification du passage important.
Un document numérisé a été converti en texte. Le contrôle doit se concentrer sur les noms, dates, chiffres et réserves qui influencent la lecture, puis comparer au document visuel.
Mis à jour le .
Vérifications prioritaires
Examiner les passages cités, les tableaux et les ruptures de page. Relever les confusions de caractères, les lignes fusionnées et les notes dont l’ordre a été modifié.
Pièges d’interprétation
Un texte fluide peut contenir une erreur numérique importante. Une recherche plein texte peut manquer un nom ou un mot mal reconnu.
Document de travail à conserver
Le journal OCR associe passage, texte reconnu, lecture vérifiée et correction. Les extraits utilisés dans la conclusion sont rattachés à leur localisation dans le document original.