
Desaparece una negación
La extracción permite algo que el original excluye. Comparar frase completa, nota y contexto. Registrar la corrección y volver a la fuente al citar; una similitud general de palabras no protege el sentido.
Guías prácticas detalladas
Pasar de una página digitalizada a información verificada: revisar caracteres, tablas, orden de lectura e idiomas antes de buscar, calcular o citar texto reconocido automáticamente.
Actualización :
Ilustración generada por IA
Un texto seleccionable puede ocultar errores: una negación perdida, un dígito sustituido, columnas mezcladas o un nombre cortado. El OCR facilita encontrar información, pero la página original sigue siendo la referencia. Distinguir una extracción útil para localizar un pasaje de otra suficientemente fiable para citar o calcular. Ninguna tasa universal sustituye la valoración según el uso.
Registrar documento, procedencia, fecha de obtención y paginación. Guardar por separado imagen y texto extraído con versiones. Una extracción nueva no debe sobrescribir pruebas utilizadas anteriormente. Comprobar que las condiciones de acceso y reutilización permiten el trabajo previsto.
Incluir página sencilla, tabla, nota, columna estrecha y escrituras presentes. Añadir todos los valores que sostienen la conclusión: importes, fechas, unidades, nombres y negaciones. Las páginas fáciles no representan bien un corpus variado; indicar la cobertura.
Leer imagen y extracción en paralelo. Revisar cero y O, uno e I, separadores decimales, signos menos y referencias. Comprobar números junto con unidades y periodos. Señalar las correcciones en la transcripción sin modificar silenciosamente el original.
Seguir títulos, párrafos, columnas, notas y celdas. Una fila de tabla no es solo una secuencia de palabras: relacionar valores y encabezados. Revisar tablas repartidas entre páginas. Conservar la página o región de origen de cada dato reutilizado.
Buscar nombre, referencia y expresión en cada escritura. Examinar acentos, caracteres árabes, puntuación y orden de cadenas mixtas. Distinguir reconocimiento de caracteres y traducción del sentido. No corregir automáticamente nombres propios con un diccionario general.
Clasificar pasajes como comprobados, corregidos con registro o no fiables. Una extracción parcial puede ayudar a localizar una página sin ser apta para calcular. Releer las citas directamente y proporcionar un localizador estable. Tras cambiar motor o ajustes, repetir pasajes difíciles, no solo comparar el volumen total.
Taller de lectura
El caso DEMO-O12 separa coincidencia de caracteres y orden de bloques antes de citar o unir.
Datos y registros ficticios para aprender: ninguno de estos resultados procede de una consulta en directo.
La página se lee primero por la columna izquierda y después por la derecha. El OCR alterna bloques y sustituye dos ceros del código por letras O; la coincidencia de caracteres no cubre ese defecto de orden.
Si la tabla supera la pantalla, desplácela horizontalmente; las flechas funcionan cuando la zona tiene el foco.
| Etapa | Dato del caso | Diagnóstico | Decisión |
|---|---|---|---|
| Imagen de dos columnas | Izquierda A1,A2; derecha B1,B2 | Orden esperado A1,A2,B1,B2. | Guardar imagen y referencias de zonas. |
| Extracción bruta | A1,B1,A2,B2 | Las columnas alternan y mezclan el argumento. | Restaurar el orden leyendo la imagen. |
| Identificador decisivo | Imagen AB-0010; OCR AB-OO10 | Dos ceros se vuelven letras O. | Corregir con registro antes de reutilizar. |
| Muestra alineada de caracteres | 2 errores de 10 000; coincidencia 99,98 % | El resultado ficticio no mide el orden de bloques. | Releer cada identificador que sostiene la conclusión. |
Abra cada propuesta para comparar su diagnóstico. Pueden seguir siendo necesarios otros controles.
No: dos errores pueden cambiar la clave utilizada.
No: estructura y caracteres se controlan por separado.
Adecuado. Revisar también el pasaje completo; conservar por separado texto bruto y transcripción corregida.
Expediente: DEMO-O12
Imagen: AB-0010; OCR bruto: AB-OO10
Orden bruto: A1,B1,A2,B2
Orden revisado: A1,A2,B1,B2
Muestra: 10 000 caracteres; errores: 2
Corrección: código y orden con referencias de página
Uso: solo pasaje controlado
Asocie al pasaje citado la página y la zona de imagen revisadas. Conserve aparte extracción bruta, transcripción corregida y motivo de cada corrección del código.
La extracción permite algo que el original excluye. Comparar frase completa, nota y contexto. Registrar la corrección y volver a la fuente al citar; una similitud general de palabras no protege el sentido.
Los títulos se encuentran, pero los párrafos alternan entre columnas. Reconstruir el orden sobre la imagen antes de resumir. Probar una frase completa: las palabras del índice pueden pertenecer a pasajes diferentes.
Un valor perdió su signo o cambió de columna. Revisar cada celda utilizada, encabezados y unidad. Calcular solo con valores verificados y documentar las celdas ilegibles sin completarlas por intuición.
Lectura guiada de un fragmento
En este ejercicio ficticio, A transcribe la lectura de la imagen original y B es el resultado OCR. Página y tabla permiten volver a la zona correcta.
Ejercicio ficticio: identificadores, valores y fechas ilustran el control. El fragmento no es una respuesta recogida en directo.
Relacionar página 7, tabla 2, encabezado y unidad EUR. No comprobar el número sin contexto.
A contiene coma decimal y espacio de agrupación. B los perdió; 125000 no significa 1 250,00.
Conservar la salida bruta y una corrección separada vinculada a la celda. Rehacer cálculos con la escala errónea.
p. 7 / table 2
A   1 250,00 EUR
B 125000 EURNo. Convenciones y errores pueden cambiar entre columnas o páginas. Justifique cada corrección decisiva con la zona original; una regla global ciega puede crear otros errores.
Referencias oficiales : Tesseract — Improving the quality of the output
LECTURA / CASO COMENTADO
Se comparan dos cadenas ficticias conservando mayúsculas, signos y los tres espacios. La referencia contiene 18 caracteres ASCII y cuatro tokens. Aquí se separan los tokens por espacios sin quitar puntuación: es la convención declarada del WER siguiente, no un ajuste universal.
Ejemplo ficticio · no son observaciones de un servicio o cliente.
En pantallas pequeñas, desplace la tabla horizontalmente.
| Control | Valor del ejemplo | Interpretación |
|---|---|---|
| Referencia revisada | REF A01 -12.50 EUR | 18 caracteres, incluidos los espacios; cuatro tokens. |
| Salida OCR sin corregir | REF A0I 12.50 EUR | 17 caracteres; el dígito 1 pasó a I y desapareció el signo menos. |
| CER: errores de caracteres | 2 / 18 × 100 ≈ 11.1 % | Una sustitución y una eliminación, divididas por los caracteres de referencia. |
| WER: convención de este ejemplo | 2 / 4 × 100 = 50 % | Dos tokens sustituidos de cuatro: identificador e importe con signo. |
| Aptitud para el uso | A01 ≠ A0I ; -12.50 ≠ 12.50 | El identificador puede señalar otro objeto y el signo invierte el valor. Volver a las zonas fuente antes de relacionar o calcular. |
Este complemento del CER no mide la veracidad del documento ni la probabilidad de que cada campo sea correcto. Aquí los dos campos útiles están alterados pese a la similitud de las cadenas.
Quitar puntuación antes de calcular podría borrar el error de signo. Comparar extracciones con las mismas reglas y examinar aparte los campos decisivos y el orden de lectura.
Referencias consultadas el
Ejercicio resuelto
Ejemplo ficticio: los valores y documentos permiten aprender el método y no describen una organización real.
La columna representa variación porcentual. El resumen automático habla de aumento.
Si la tabla supera la pantalla, desplácela horizontalmente; las flechas funcionan cuando la zona tiene el foco.
| Fuente | Texto leído |
|---|---|
| Imagen de la tabla | −12,5 |
| Extracción OCR | 12.5 |
El valor es −12,5 %, una bajada en esta tabla. Cambiar coma por punto puede normalizar el formato; perder el signo cambia el sentido. Corregir también resumen y cálculos derivados, manteniendo identificable la extracción inicial.
Si un guion puede ser un código de ausencia, leer leyenda y alineación; no interpretarlo automáticamente como signo negativo.
Guardar página, posición de celda, imagen legible, OCR bruto y corrección justificada.
REFERENCIAS DOCUMENTADAS
ALTO 4.4 define WC para palabras y CC para caracteres con extremos opuestos. Son metadatos OCR, no exactitud medida en su corpus.
| Referencia | Valor o forma | Qué identifica |
|---|---|---|
| WC | 0 → 1 | 0 indica incertidumbre y 1 seguridad según el motor; un valor alto no sustituye leer la imagen. |
| CC | 0 → 9 | Un número por carácter: 0 seguro y 9 incierto. No interpretar 9 como mayor confianza. |
| HPOS / VPOS | MeasurementUnit | Posiciones horizontal y vertical en la unidad declarada; no presuponer píxeles. |
| CONTENT | String | Contenido reconocido de una unidad textual; conservar vínculo con página y región. |
| ReadingOrder | ALTO 4.3+ | Orden explícito de lectura introducido en 4.3; comprobar versión antes de esperar ese elemento. |
Conservar versión, unidad, texto y coordenadas juntos. Los perfiles institucionales pueden diferir; BnF documenta variantes ALTO. Un valor ausente no significa confianza cero.
No. WC es confianza del motor para una unidad textual, no exactitud de caracteres observada. Comparar pasajes con una transcripción de referencia y describir la muestra, sin certificar el corpus a partir del valor.
Documentación consultada el .
REFERENCIAS DOCUMENTADAS
Esta reproducción muestra una apertura del ejemplar de la Biblia de Gutenberg de la Library of Congress, con marcas de procedencia en la contracubierta interior. Procede de WDL7782 difundido por Wikimedia Commons. Separar obra e historia del ejemplar.
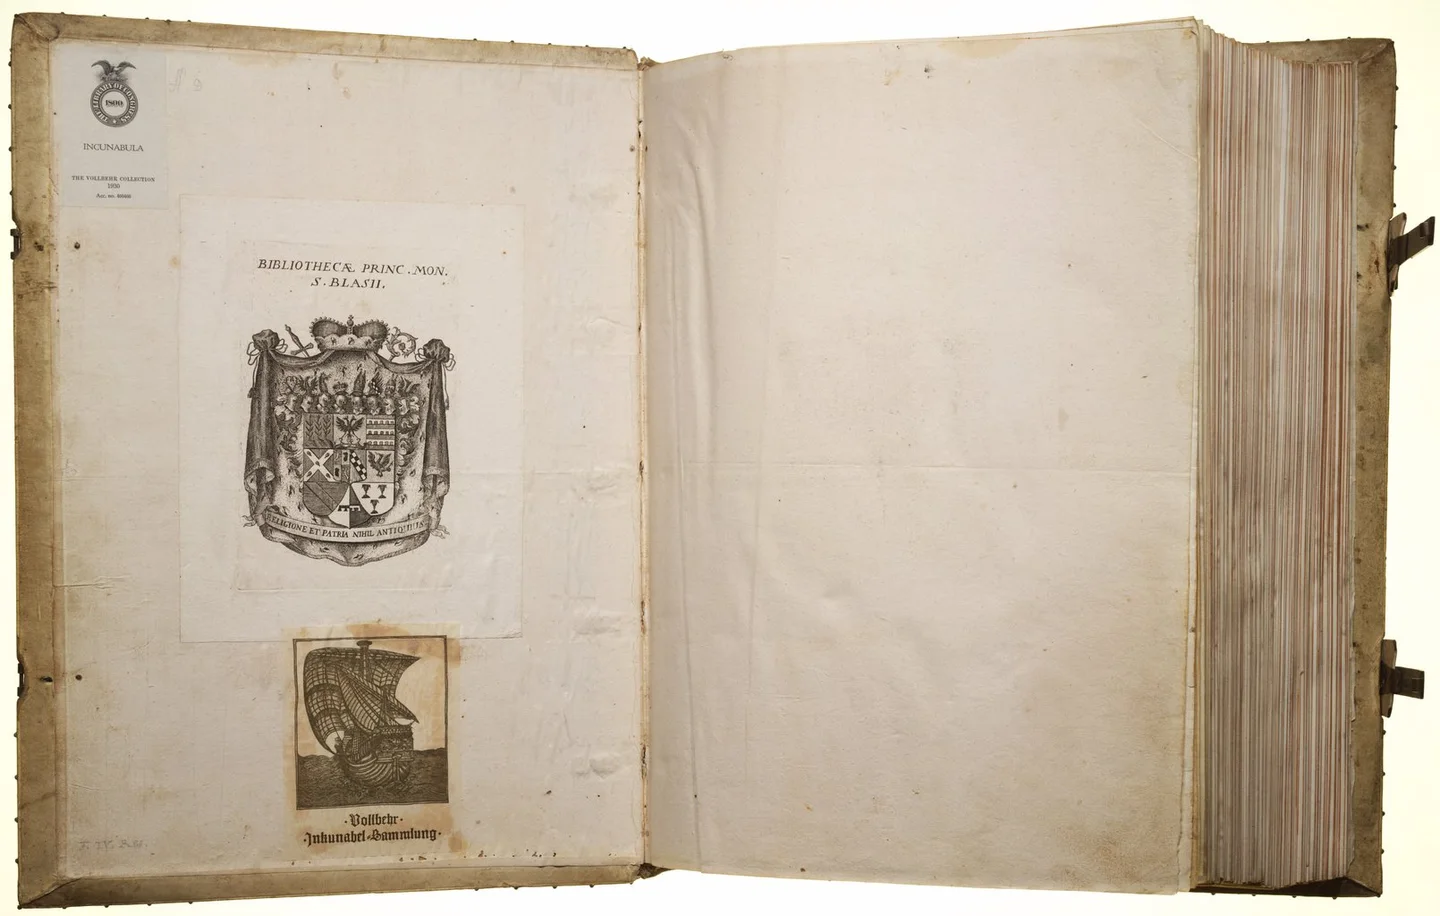
Apertura del ejemplar de la Biblia de Gutenberg de la Library of Congress: interior de cubierta con exlibris, etiqueta Vollbehr de 1930 y hoja de guarda.
Reproducción documental auténtica · Library of Congress · World Digital Library · Wikimedia Commons · Fuente · Reutilización
Reproducción señalada como dominio público en su ficha. Reducida y convertida a WebP sin recorte. Fecha de fotografía no indicada.
| Referencia | Valor o forma | Qué identifica |
|---|---|---|
| Biblia latina | Mainz · c. 1455 | La exposición institucional sitúa la impresión en Maguncia, probablemente terminada a finales de 1455. |
| Language | Latín | Texto latino de la Vulgata; el idioma de una etiqueta no es el de todo el libro. |
| Material | Vitela | Ejemplar impreso sobre vitela según la descripción institucional. |
| Vollbehr | 1930 | Año de adquisición de la colección Vollbehr por la biblioteca, visible también en la etiqueta de la reproducción. |
| WDL | 7782 | Identificador de la ficha World Digital Library citada en la procedencia, no paginación. |
En OCR, separar texto, anotaciones, exlibris y etiquetas. Atribuir cada información a su región y función. Aquí no consta fecha de digitalización o fotografía; no deducirla de 1455 o 1930.
Es una marca de colección, no año de impresión. La descripción institucional documenta aparte la adquisición en 1930. Conservar distinción y ejemplar: una marca de este volumen no describe todos los ejemplares de la edición.
Documentación consultada el .
REFERENCIAS DOCUMENTADAS
Las partes ISO 19005 especifican conservación del aspecto y recursos. La tabla compara perfiles documentados, no comprobaciones sobre los PDF del visitante. Identifique el perfil exacto antes de leer un informe.
| Referencia | Valor o forma | Qué identifica |
|---|---|---|
| PDF/A-1 | ISO 19005-1:2005 | Primera parte basada en PDF 1.4. Busca reproducibilidad de presentación; la extensión .pdf no acredita el perfil. |
| PDF/A-2 | ISO 19005-2:2011 | Basada en PDF 1.7, permite funciones adicionales e integrar PDF/A según sus reglas. No admite por ello adjuntos de cualquier formato. |
| PDF/A-3 | ISO 19005-3:2012 | Permite archivos integrados de cualquier formato. La conformidad del contenedor no hace esos adjuntos preservables, accesibles ni conformes a PDF/A. |
| PDF/A-4f | ISO 19005-4:2020 | Perfil de la parte 4 basado en PDF 2.0 con archivos integrados de otros formatos. Su nombre no revela naturaleza ni calidad del adjunto. |
| pdfaid:part / pdfaid:conformance | 1 / B | Ejemplo de declaración XMP para PDF/A-1b: part vale 1 y conformance B. Es conformidad declarada, no validación superada. |
| PDF/UA | ISO 14289 | Familia de accesibilidad PDF. Un archivo puede aspirar a PDF/A y PDF/UA; PDF/A por sí solo no establece accesibilidad. |
Conserve archivo, perfil probado, herramienta y versión, reglas y resultados. OCR, orden de lectura, adjuntos y firmas requieren controles distintos. El formato no certifica autor, fecha ni afirmaciones.
No. La selección no demuestra estructura semántica, orden correcto ni descripciones adecuadas. Revise requisitos pertinentes y lea con herramientas de asistencia.
Documentación consultada el .
Ayuda a priorizar revisión, pero no sustituye comparar pasajes decisivos. Un solo error puede invertir el sentido de una frase.
Adaptar el trabajo a la decisión. Para una cita, comprobar pasaje y contexto; para un cálculo, todas las celdas utilizadas.
Comparar extracciones nuevas en los mismos pasajes. Conservar la imagen inicial y registrar transformaciones para distinguir fuente y archivos preparados.
No. Reconocimiento y traducción son etapas distintas con errores y controles propios. Conservar el pasaje en su idioma original.
Los números, nombres, fechas y reservas de los que depende la conclusión. Un error significativo puede justificar el examen de las tablas o pasajes producidos por el mismo proceso de reconocimiento.
REFERENCIAS DOCUMENTADAS
La distancia de Levenshtein cuenta las operaciones mínimas para convertir una referencia en texto candidato. Examina una transcripción o fragmento, no la fidelidad de una traducción ni la verdad de una respuesta.
| Referencia | Valor o forma | Qué identifica |
|---|---|---|
| S / D / I | reference → candidate | S sustituye una unidad de referencia; D la elimina; I añade una unidad al candidato. Cada operación cuesta 1. Intercambiar letras no es una operación especial. |
| N / M | H+S+D / H+S+I | N es la longitud de referencia tras el tratamiento declarado. Con H unidades iguales, N = H + S + D; la longitud del candidato es H + S + I. |
| CER / WER (%) | 100 × (S+D+I) / N | El porcentaje es 100 × (S + D + I) / N y puede superar el 100 %: a frente a aaa requiere dos inserciones para una unidad de referencia. |
| units / profile | code points · White_Space 17.0.0 · raw / NFC | Carácter cuenta puntos de código, no grafemas ni UTF-16. Palabra divide por los 25 separadores White_Space de Unicode 17.0.0 sin análisis lingüístico. Se conservan mayúsculas y puntuación; NFC es opcional. |
| tie-break | H → S → D → I | Varios alineamientos pueden tener coste mínimo. El retroceso prioriza H, S, D e I. Para ab frente a ba se eligen dos sustituciones; una eliminación e inserción pueden tener el mismo coste. |
| N = 0 | undefined rate | Con N = 0 se muestran operaciones y tasa indefinida, incluso para dos textos vacíos. JiWER 4 establece otras convenciones: compare solo bajo el mismo contrato. |
Ejemplo didáctico original, sin medir un motor OCR real.
Hasta 200 puntos de código por texto antes y después de NFC. Se conservan caso y puntuación. Saltos LF.
Las herramientas calculan en el navegador sin transmitir los textos.
Comparación calculada · WER · raw · N = 3 · E = 1
Sustituciones S : 0Eliminaciones D : 0Inserciones I : 1Unidades iguales H : 3
Referencia vacía: se cuentan operaciones pero la tasa local es indefinida.
Alineamiento: coste mínimo y prioridad H, S, D, I al retroceder. Otros óptimos pueden repartir errores de otra forma.
∅ significa ausencia de unidad. La notación JSON permite reconocer espacios y saltos.
Se muestran los primeros 100 pasos; los recuentos incluyen toda la alineación.
| Paso | Unidad de referencia | Unidad del candidato | Operación |
|---|---|---|---|
| 1 | "le" | "le" | Unidades iguales H |
| 2 | "chat" | "chat" | Unidades iguales H |
| 3 | ∅ | "noir" | Inserciones I |
| 4 | "dort" | "dort" | Unidades iguales H |
{"reference":"le chat dort","candidate":"le chat noir dort"}N = H + S + D; M = H + S + I E = S + D + I N > 0 → rate = 100 × E/N N = 0 → undefined
Los ejemplos usan JSON con escapes Unicode; estos no definen la unidad de cálculo.
| Texto de referencia comprobado | Texto candidato | Fórmula y perfil | N | E | Tasa de error (%) |
|---|---|---|---|---|---|
| "le chat dort" | "le chat noir dort" | WER · raw | 3 | 1 | 33,333333 |
| "le chat dort" | "le chat noir dort" | CER · raw | 12 | 5 | 41,666667 |
| "a" | "aaa" | CER · raw | 1 | 2 | 200 |
| "cat" | "" | CER · raw | 3 | 3 | 100 |
| "" | "x" | CER · raw | 0 | 1 | Indefinida |
| "" | "" | CER · raw | 0 | 0 | Indefinida |
| "ab" | "ba" | CER · raw | 2 | 2 | 100 |
| "\u00e9" | "e\u0301" | CER · raw | 1 | 2 | 200 |
| "\u00e9" | "e\u0301" | CER · NFC | 1 | 0 | 0 |
| "Le chat." | "le chat" | WER · raw | 2 | 2 | 100 |
| "les chats" | "les chats" | WER · raw | 2 | 0 | 0 |
| "les chats" | "les chats" | CER · raw | 10 | 1 | 10 |
| "un\u00a0chat" | "un chat" | WER · raw | 2 | 0 | 0 |
| "\u6587\u672c" | "\u6587\u4f53" | WER · raw | 1 | 1 | 100 |
| "\u6587\u672c" | "\u6587\u4f53" | CER · raw | 2 | 1 | 50 |
| "\u0634\u064e" | "\u0634" | CER · raw | 2 | 1 | 50 |
| "\ud83e\udded" | "\ud83e\udded\ud83e\udded" | CER · raw | 1 | 1 | 100 |
| "un\u200bchat" | "un chat" | WER · raw | 1 | 2 | 200 |
White_Space se fija en Unicode 17.0.0; NFC usa el motor del navegador. No se quitan acentos, caso ni puntuación.
White_Space data from PropList-17.0.0.txt. Copyright © 2025 Unicode, Inc.

UNICODE LICENSE V3

COPYRIGHT AND PERMISSION NOTICE

Copyright © 1991-2026 Unicode, Inc.

NOTICE TO USER: Carefully read the following legal agreement. BY
DOWNLOADING, INSTALLING, COPYING OR OTHERWISE USING DATA FILES, AND/OR
SOFTWARE, YOU UNEQUIVOCALLY ACCEPT, AND AGREE TO BE BOUND BY, ALL OF THE
TERMS AND CONDITIONS OF THIS AGREEMENT. IF YOU DO NOT AGREE, DO NOT
DOWNLOAD, INSTALL, COPY, DISTRIBUTE OR USE THE DATA FILES OR SOFTWARE.

Permission is hereby granted, free of charge, to any person obtaining a
copy of data files and any associated documentation (the "Data Files") or
software and any associated documentation (the "Software") to deal in the
Data Files or Software without restriction, including without limitation
the rights to use, copy, modify, merge, publish, distribute, and/or sell
copies of the Data Files or Software, and to permit persons to whom the
Data Files or Software are furnished to do so, provided that either (a)
this copyright and permission notice appear with all copies of the Data
Files or Software, or (b) this copyright and permission notice appear in
associated Documentation.

THE DATA FILES AND SOFTWARE ARE PROVIDED "AS IS", WITHOUT WARRANTY OF ANY
KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF
MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT OF
THIRD PARTY RIGHTS.

IN NO EVENT SHALL THE COPYRIGHT HOLDER OR HOLDERS INCLUDED IN THIS NOTICE
BE LIABLE FOR ANY CLAIM, OR ANY SPECIAL INDIRECT OR CONSEQUENTIAL DAMAGES,
OR ANY DAMAGES WHATSOEVER RESULTING FROM LOSS OF USE, DATA OR PROFITS,
WHETHER IN AN ACTION OF CONTRACT, NEGLIGENCE OR OTHER TORTIOUS ACTION,
ARISING OUT OF OR IN CONNECTION WITH THE USE OR PERFORMANCE OF THE DATA
FILES OR SOFTWARE.

Except as contained in this notice, the name of a copyright holder shall
not be used in advertising or otherwise to promote the sale, use or other
dealings in these Data Files or Software without prior written
authorization of the copyright holder.
Ejemplos originales, no mediciones de software. Una tasa baja no garantiza orden de lectura ni nombres o importes correctos. Compruebe la referencia con el documento. Los campos convierten saltos de línea a LF.
La confianza es una estimación del motor. CER o WER compara un resultado con una referencia y un perfil elegidos. Conserve ambos con sus métodos; ninguno sustituye revisar el pasaje importante.
Documentación consultada el .
PROFUNDIZACIÓN / PRÁCTICA
Un documento digitalizado se ha convertido en texto. El control debe centrarse en los nombres, fechas, números y reservas que influyen en la lectura, y luego comparar con el documento visual.
Actualizado el .
Examinar los pasajes citados, las tablas y las rupturas de página. Repare las confusiones de caracteres, las líneas fusionadas y las notas cuya orden ha sido modificada.
Un texto fluido puede contener un grave error digital. Una búsqueda de texto completo puede faltar un nombre o una palabra mal reconocida.
El diario OCR combina paso, texto reconocido, lectura verificada y corrección. Los extractos utilizados en la conclusión están relacionados con su ubicación en el documento original.